Machine learning vs deep learning : différences et exemples
Machine learning et deep learning sont souvent présentés comme deux technologies rivales. Ce n’est pas le cas : le deep learning est une famille de méthodes à l’intérieur du machine learning, qui lui-même fait partie de l’intelligence artificielle. Les deux approches diffèrent en revanche par le type de données qu’elles traitent, la quantité d’exemples nécessaire, la puissance de calcul et la lisibilité de leurs décisions. Ce guide clarifie ces différences et indique quand choisir l’une ou l’autre.
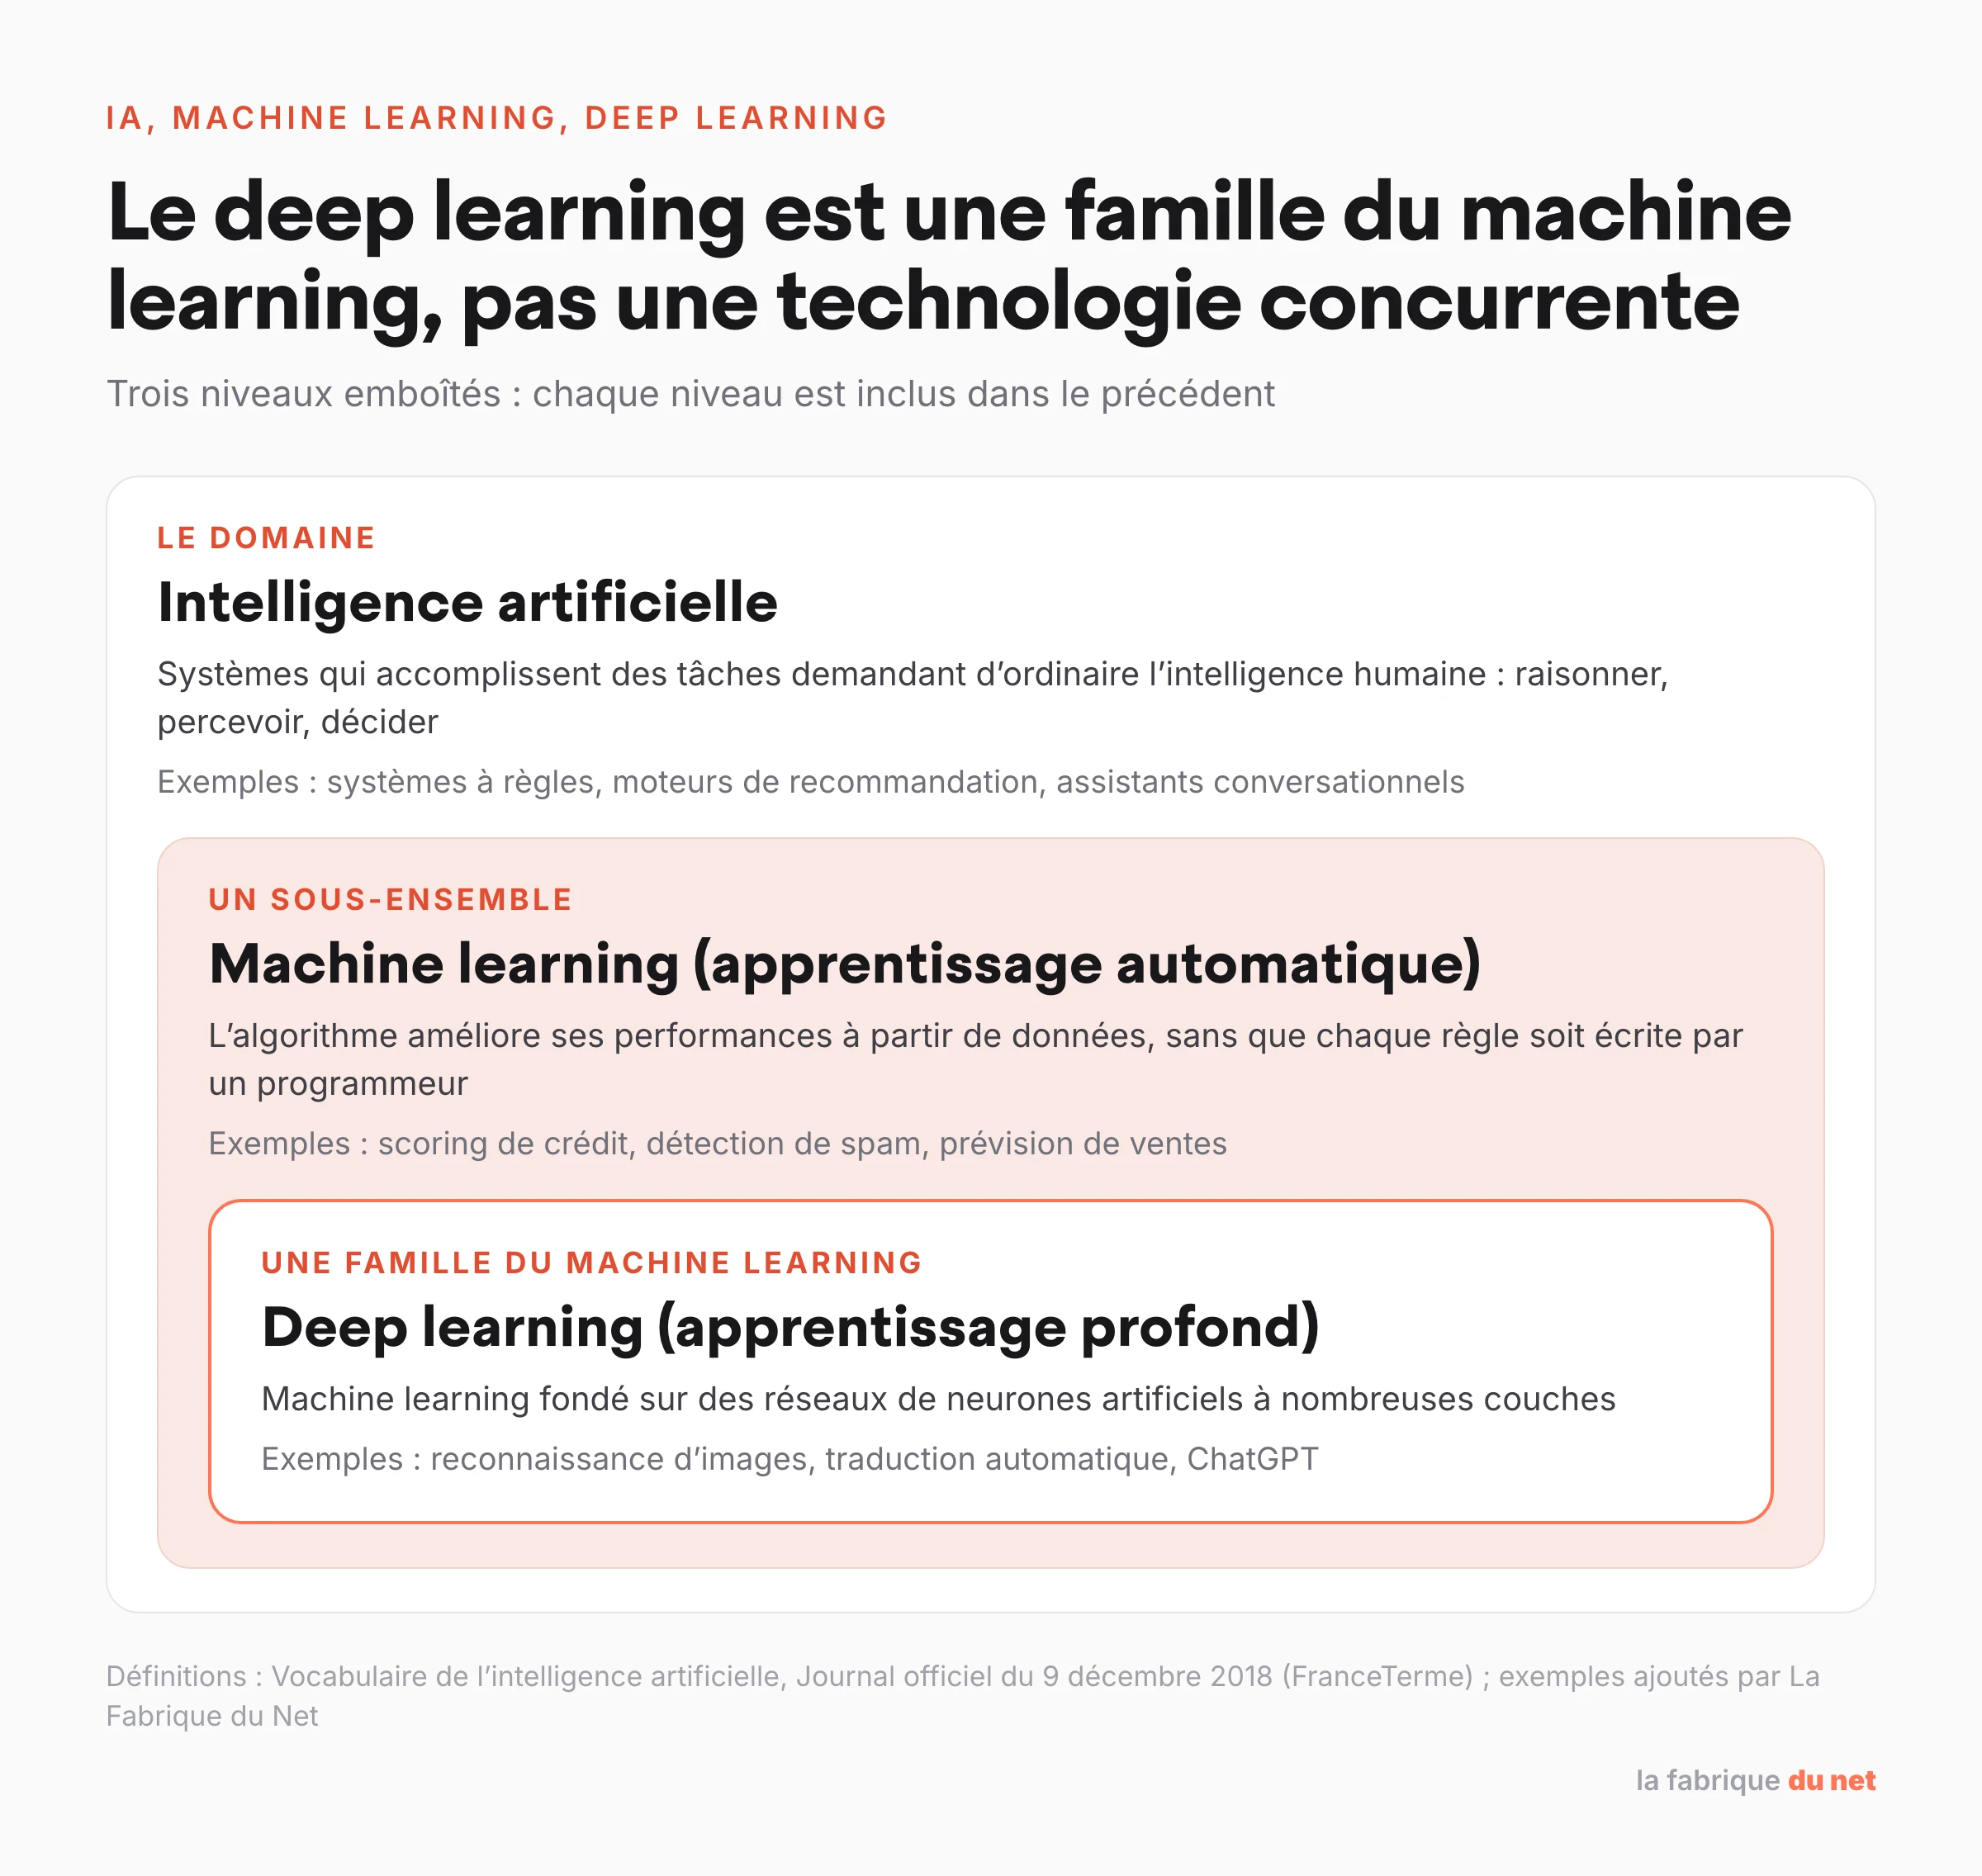
Réponse courte : le machine learning (apprentissage automatique) désigne les algorithmes qui améliorent leurs performances à partir de données au lieu d’être programmés règle par règle. Le deep learning (apprentissage profond) en est un sous-ensemble qui utilise des réseaux de neurones artificiels à nombreuses couches. Le machine learning classique fonctionne bien sur des données tabulaires et des volumes modestes, avec des modèles plus faciles à expliquer ; le deep learning s’impose sur les images, le son et le texte, au prix de beaucoup de données et de calcul.
IA, machine learning et deep learning : qui contient quoi
La terminologie officielle française tranche la question. Le vocabulaire de l’intelligence artificielle publié au Journal officiel du 9 décembre 2018 définit :
- l’apprentissage automatique (machine learning, synonyme « apprentissage machine ») comme le « processus par lequel un algorithme évalue et améliore ses performances sans l’intervention d’un programmeur, en répétant son exécution sur des jeux de données jusqu’à obtenir, de manière régulière, des résultats pertinents » ; le texte précise qu’il relève de l’intelligence artificielle ;
- l’apprentissage profond (deep learning) comme un « apprentissage automatique qui utilise un réseau de neurones artificiels composé d’un grand nombre de couches dont chacune correspond à un niveau croissant de complexité dans le traitement et l’interprétation des données ».
Autrement dit, tout deep learning est du machine learning, mais l’inverse est faux. Google Cloud résume la même hiérarchie : le deep learning est un type spécialisé de machine learning, et le machine learning une discipline fondamentale du domaine plus vaste de l’intelligence artificielle.
Comment fonctionne le machine learning
Un modèle de machine learning part d’exemples. Pour prédire si un client risque de résilier, on lui fournit l’historique de milliers de clients décrits par des variables (ancienneté, montant des factures, nombre de réclamations) et l’issue observée. L’algorithme ajuste ses paramètres jusqu’à reproduire au mieux ces issues, puis applique ce qu’il a appris à de nouveaux clients.
Point clé : dans le machine learning classique, ce sont généralement des humains qui choisissent et préparent les variables d’entrée (le « feature engineering »). La qualité du modèle dépend largement de ce travail de préparation.
Les trois grands types d’apprentissage
- Apprentissage supervisé : les données d’entraînement sont annotées avec le résultat attendu (ce courriel est un spam, ce dossier a fait défaut). C’est le cas le plus courant en entreprise : classification, prévision, scoring.
- Apprentissage non supervisé : les données ne sont pas annotées ; l’algorithme regroupe ce qui se ressemble. Usage typique : segmenter une base clients.
- Apprentissage par renforcement : un agent apprend par essais et erreurs, en recevant des récompenses ou des pénalités. Usage typique : jeux, robotique, optimisation de décisions séquentielles.
Google Cloud et IBM mentionnent aussi l’apprentissage partiellement supervisé, où seule une partie des données est annotée. Ces trois modes existent aussi bien en machine learning classique qu’en deep learning.
Les algorithmes courants
Régressions linéaire et logistique, arbres de décision, forêts aléatoires, gradient boosting, k plus proches voisins, k-means pour le regroupement : ce sont les outils de base du machine learning classique. La bibliothèque Python open source scikit-learn les réunit et sert souvent de point d’entrée.
Comment fonctionne le deep learning
Un réseau de neurones artificiels est composé de couches de nœuds : une couche d’entrée, une ou plusieurs couches cachées et une couche de sortie. Chaque nœud pondère les signaux qu’il reçoit et transmet un résultat à la couche suivante. Le réseau devient « profond » quand il empile de nombreuses couches cachées ; IBM retient le seuil de plus de trois couches, entrées et sortie comprises.
La différence pratique avec le machine learning classique tient à la préparation des données : un réseau profond peut ingérer des données brutes (pixels d’une image, mots d’un texte) et apprendre lui-même les caractéristiques utiles, couche après couche. Il n’a pas besoin qu’un humain lui dise que la forme des oreilles distingue un chat d’un chien. En contrepartie, il lui faut beaucoup plus d’exemples et de calcul.
Les principales architectures
- Réseaux convolutifs (CNN) : adaptés aux images, ils filtrent différentes zones de l’image avant de les recombiner.
- Réseaux récurrents (RNN, LSTM) : conçus pour les séquences et les séries temporelles, ils gardent une « mémoire » des étapes précédentes.
- Transformers : introduits en 2017 par l’article « Attention Is All You Need », ils reposent sur un mécanisme d’attention et sont à la base des grands modèles de langage.
- Réseaux antagonistes génératifs (GAN) : deux réseaux s’affrontent, l’un générant des contenus, l’autre tentant de les distinguer des vrais.
Les deux bibliothèques open source les plus répandues pour le deep learning sont PyTorch et TensorFlow.
Machine learning vs deep learning : les différences clés
| Critère | Machine learning classique | Deep learning |
|---|---|---|
| Place | Sous-ensemble de l’IA | Sous-ensemble du machine learning |
| Données de prédilection | Données structurées, en tableaux (ventes, transactions, fiches clients) | Données non structurées : images, son, vidéo, texte |
| Volume de données | Fonctionne avec des jeux de taille modeste | Demande en général beaucoup plus d’exemples |
| Préparation des variables | Largement manuelle (feature engineering) | Le réseau apprend lui-même les caractéristiques |
| Calcul | Un ordinateur standard suffit souvent | Entraînement sur GPU ou TPU, souvent dans le cloud |
| Explicabilité | Plus lisible (arbres, coefficients) | Difficile à interpréter, d’où le champ de l’IA explicable |
| Exemples | Scoring de crédit, détection de fraude, prévision de la demande, détection de spam | Reconnaissance d’images, transcription vocale, traduction, assistants conversationnels |
Données structurées : le machine learning classique reste souvent devant
Le deep learning n’est pas meilleur partout. Une étude de référence, « Why do tree-based models still outperform deep learning on tabular data? » (Grinsztajn, Oyallon et Varoquaux, 2022), conclut que sur des données tabulaires de taille moyenne (de l’ordre de 10 000 exemples), les modèles à base d’arbres comme les forêts aléatoires et le gradient boosting restent à l’état de l’art, avant même de tenir compte de leur rapidité. Pour un fichier clients ou un historique de ventes, c’est donc souvent par là qu’il faut commencer.
Images, son, texte : le deep learning s’impose
Dès que la donnée est non structurée, la capacité du deep learning à apprendre ses propres représentations fait la différence. La reconnaissance d’images, la transcription de la parole, la traduction automatique et les modèles de langage reposent aujourd’hui sur des réseaux profonds. Le Journal officiel cite d’ailleurs la détection d’objets dans les images et la traduction automatique comme usages typiques de l’apprentissage profond.
Interprétabilité et contraintes réglementaires
Un arbre de décision ou une régression permettent d’expliquer pourquoi un dossier a été refusé. Un réseau profond, avec des millions de paramètres, est beaucoup plus opaque. Dans les domaines où une décision doit pouvoir être justifiée (crédit, recrutement, santé), cette différence pèse dans le choix, et les méthodes d’IA explicable ne la comblent qu’en partie.
ChatGPT, IA générative : du deep learning
Les assistants conversationnels comme ChatGPT reposent sur des grands modèles de langage, qui sont des réseaux de neurones profonds. Le rapport technique de GPT-4 publié par OpenAI en 2023 décrit ainsi le modèle comme un modèle fondé sur l’architecture Transformer, pré-entraîné à prédire le mot suivant dans un document, puis amélioré par une phase d’alignement après l’entraînement. L’IA générative est donc une application du deep learning, et non une troisième catégorie à côté du machine learning.
Quand choisir le machine learning ou le deep learning
- Vos données tiennent dans un tableur ou une base (clients, commandes, transactions) : commencez par le machine learning classique. Plus rapide, moins coûteux, plus facile à expliquer.
- Vous traitez des images, de l’audio, de la vidéo ou du texte libre : le deep learning est généralement nécessaire, souvent en partant d’un modèle déjà entraîné plutôt que de zéro.
- Vous avez peu d’exemples annotés : le machine learning classique, ou un modèle profond pré-entraîné qu’on adapte, plutôt qu’un réseau entraîné de zéro.
- La décision doit être justifiée (refus de crédit, tri de candidatures) : privilégiez les modèles interprétables, ou prévoyez un dispositif d’explication.
- Le besoin est couvert par un service existant (transcription, traduction, analyse de documents) : utiliser un outil du marché coûte souvent moins cher que développer un modèle. Notre comparatif des solutions d’IA pour les entreprises recense ces offres.
Dans les deux cas, la qualité des données annotées conditionne le résultat ; voir notre article sur le data labeling. Pour un projet sur mesure, l’annuaire recense des agences spécialisées en intelligence artificielle.
Questions fréquentes
Quelle est la différence entre machine learning et deep learning ?
Le deep learning est une forme de machine learning qui utilise des réseaux de neurones à nombreuses couches. Le machine learning classique s’appuie sur des algorithmes plus simples (arbres, régressions) et sur des variables préparées par des humains ; le deep learning apprend lui-même ses représentations à partir de données brutes, ce qui exige plus de données et de calcul.
Le deep learning fait-il partie du machine learning ?
Oui. Le Journal officiel définit l’apprentissage profond comme un apprentissage automatique utilisant un réseau de neurones artificiels à nombreuses couches. C’est un sous-ensemble du machine learning, lui-même branche de l’intelligence artificielle.
Machine learning ou deep learning : lequel est le meilleur ?
Aucun dans l’absolu. Sur des données tabulaires de taille moyenne, les modèles à base d’arbres font souvent mieux que les réseaux profonds, selon l’étude de Grinsztajn et al. (2022). Sur les images, le son et le texte, le deep learning domine. Le bon choix dépend des données, du volume d’exemples et du besoin d’explication.
ChatGPT, c’est du deep learning ou du machine learning ?
Les deux, puisque le deep learning est une forme de machine learning. Plus précisément, ChatGPT repose sur un grand modèle de langage de type Transformer, c’est-à-dire un réseau de neurones profond.
Quelle est la différence entre IA, machine learning, deep learning et data science ?
L’IA est le domaine global. Le machine learning en est la branche qui apprend à partir de données, et le deep learning la sous-branche fondée sur les réseaux de neurones profonds. La data science est une discipline voisine, pas un niveau de cette hiérarchie : elle couvre la collecte, le nettoyage, l’analyse et la visualisation des données, et utilise le machine learning parmi d’autres outils.
Peut-on apprendre le deep learning sans connaître le machine learning ?
C’est possible avec les bibliothèques actuelles, mais déconseillé. Les notions de base du machine learning (jeu d’entraînement et de test, surapprentissage, métriques d’évaluation, préparation des données) s’appliquent telles quelles au deep learning, et permettent de savoir quand un modèle plus simple suffit.
Quelle est la différence entre le machine learning et l’intelligence artificielle ?
L’intelligence artificielle désigne l’ensemble des systèmes capables d’accomplir des tâches qui demandent d’ordinaire l’intelligence humaine, y compris des systèmes à règles écrites à la main. Le machine learning en est une partie : les systèmes qui apprennent leurs règles à partir de données.
Quel est le principe du machine learning ?
Fournir à un algorithme de nombreux exemples pour qu’il ajuste ses paramètres jusqu’à produire des résultats pertinents, puis l’appliquer à de nouvelles données. C’est la définition retenue par le Journal officiel : un algorithme qui évalue et améliore ses performances en répétant son exécution sur des jeux de données.
Quels sont les 3 types de machine learning ?
L’apprentissage supervisé (données annotées), l’apprentissage non supervisé (données non annotées, regroupement) et l’apprentissage par renforcement (essais, erreurs et récompenses). On y ajoute parfois l’apprentissage partiellement supervisé.
Quels sont les 3 types d’intelligence artificielle ?
IBM distingue l’IA étroite ou faible (ANI), conçue pour une tâche précise, l’IA générale (AGI), qui égalerait l’humain, et la superintelligence (ASI), qui le dépasserait. Selon IBM, les deux formes dites « fortes » (AGI et ASI) n’existent pas encore et restent des sujets de recherche.
Comment traduire deep learning ?
Le terme français officiel est « apprentissage profond », publié au Journal officiel du 9 décembre 2018. Machine learning se traduit par « apprentissage automatique » ou « apprentissage machine ».
Notez cet article